2026 年了,AI 给的参考文献,还有多少是编的?——ChatGPT 篇
一、引言
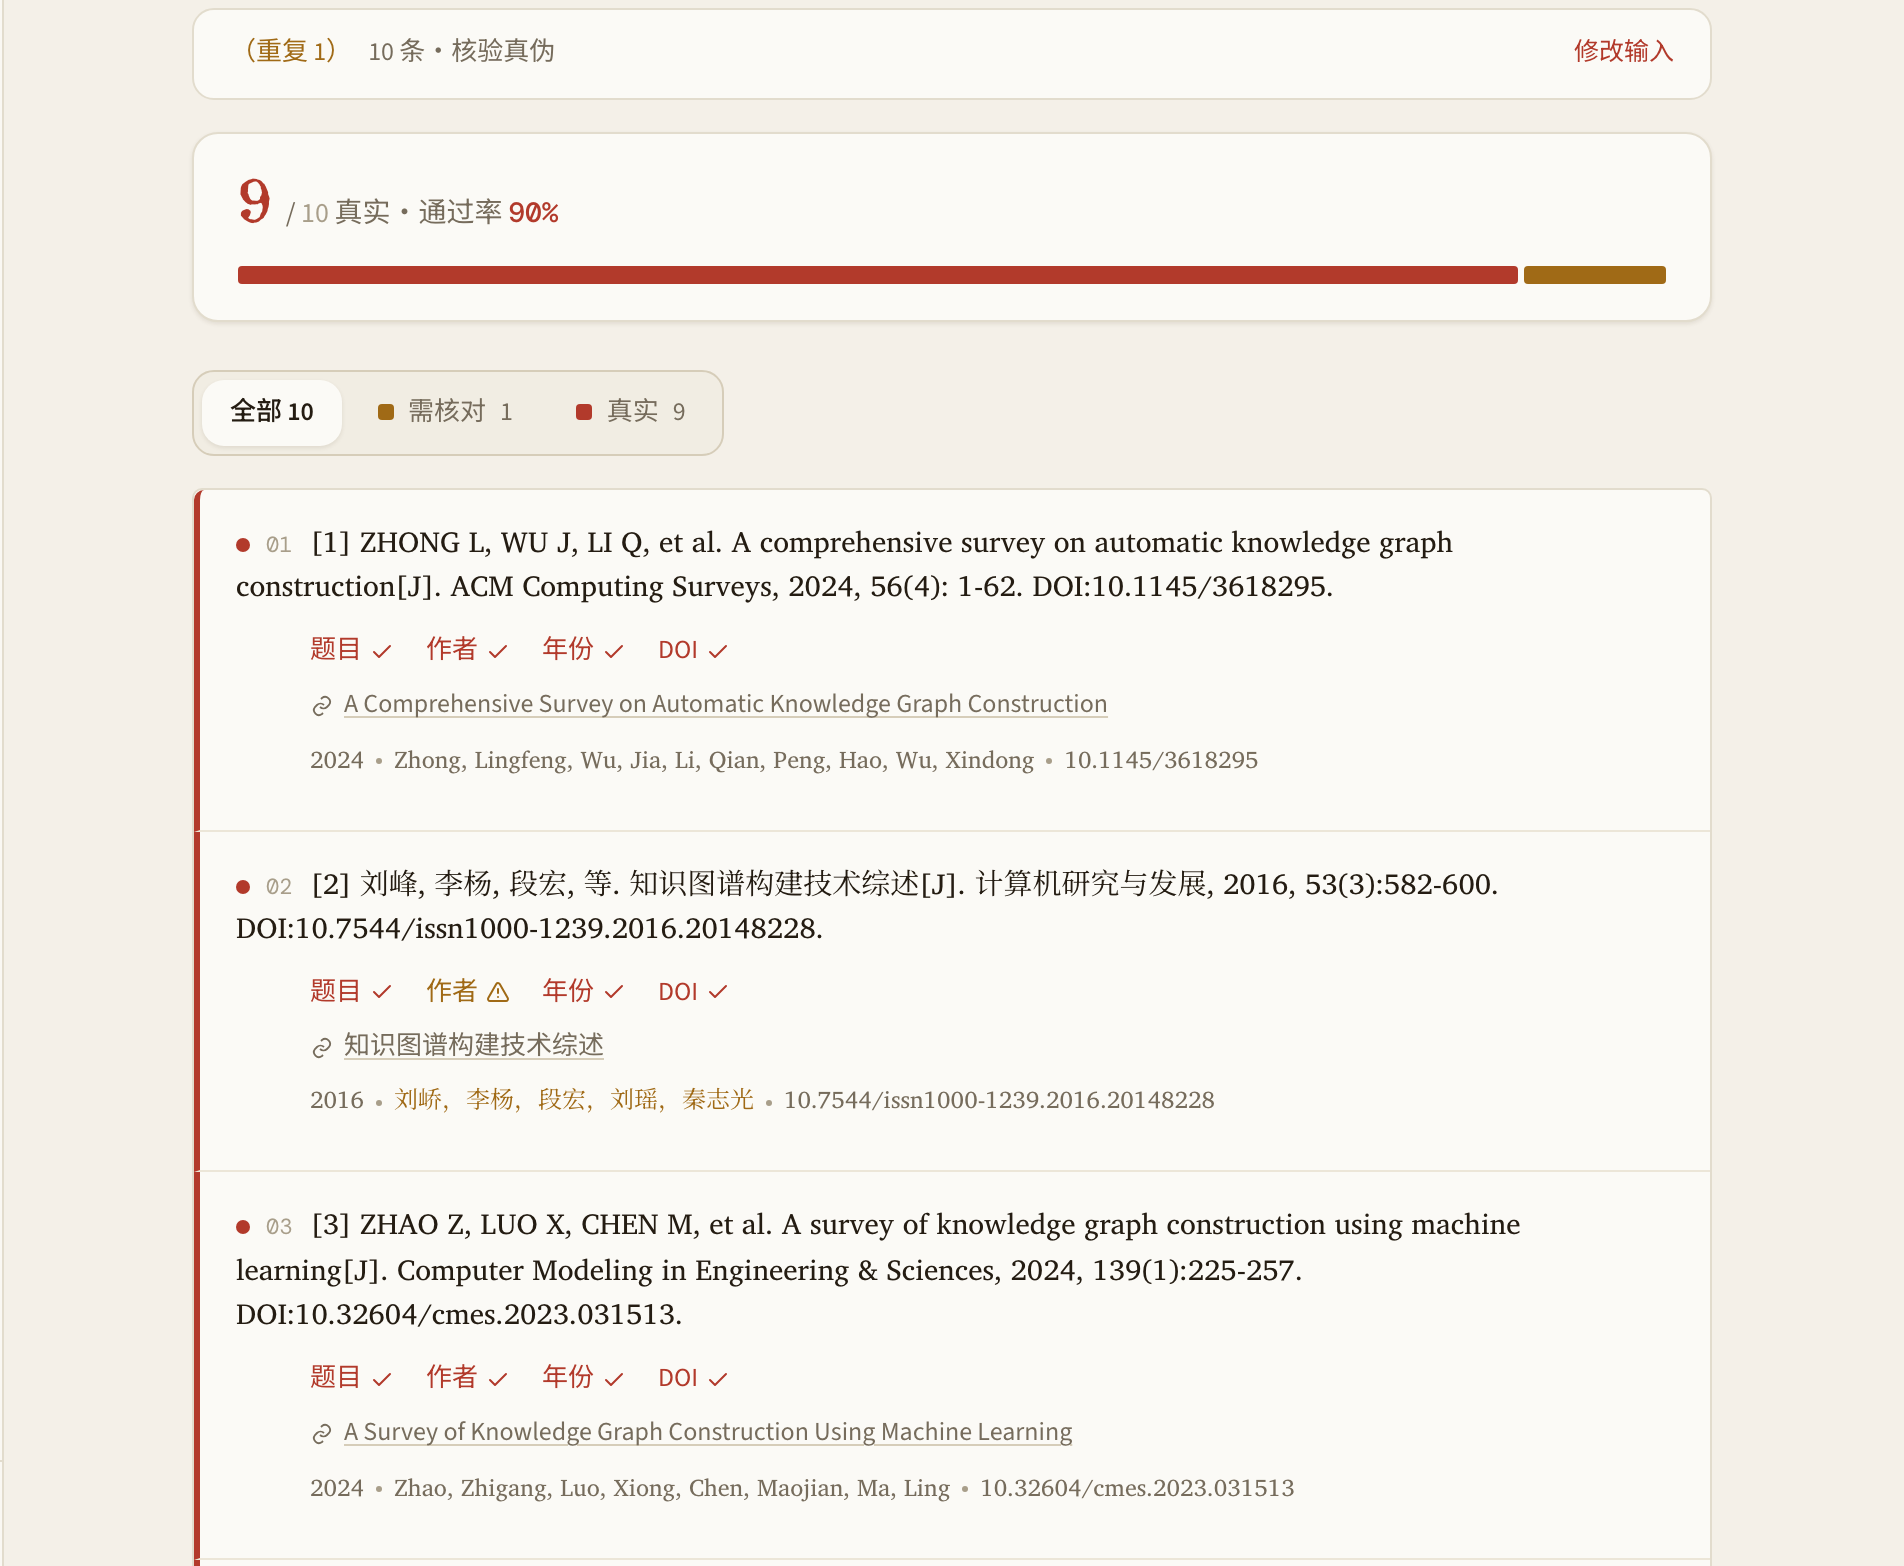
上一篇豆包给出的第一条参考文献,是《计算机研究与发展》上一篇真实综述配错了作者和年份。这次 ChatGPT 也给了这篇:
刘峰, 李杨, 段宏, 等. 知识图谱构建技术综述[J]. 计算机研究与发展, 2016, 53(3):582-600.
期刊、年份、卷期页码全对,第二、第三作者也对。唯独第一作者刊方记录是刘峤,条目写成了刘峰。一字之差,按这个署名去检索,检索不到这篇文章。
DeepSeek 篇 66 条宜引 16 条(24%),豆包篇 62 条宜引 28 条(45%)。ChatGPT 是同一套测试的第三家。
ChatGPT 给的参考文献,整表贴进今日宜引文,每条给出命中的数据库或刊方记录与逐字段比对,DOI 打开是别的文章的条目在此现形。
二、方法
2.1 测试设置
测试对象:ChatGPT 网页版,免费版账号。
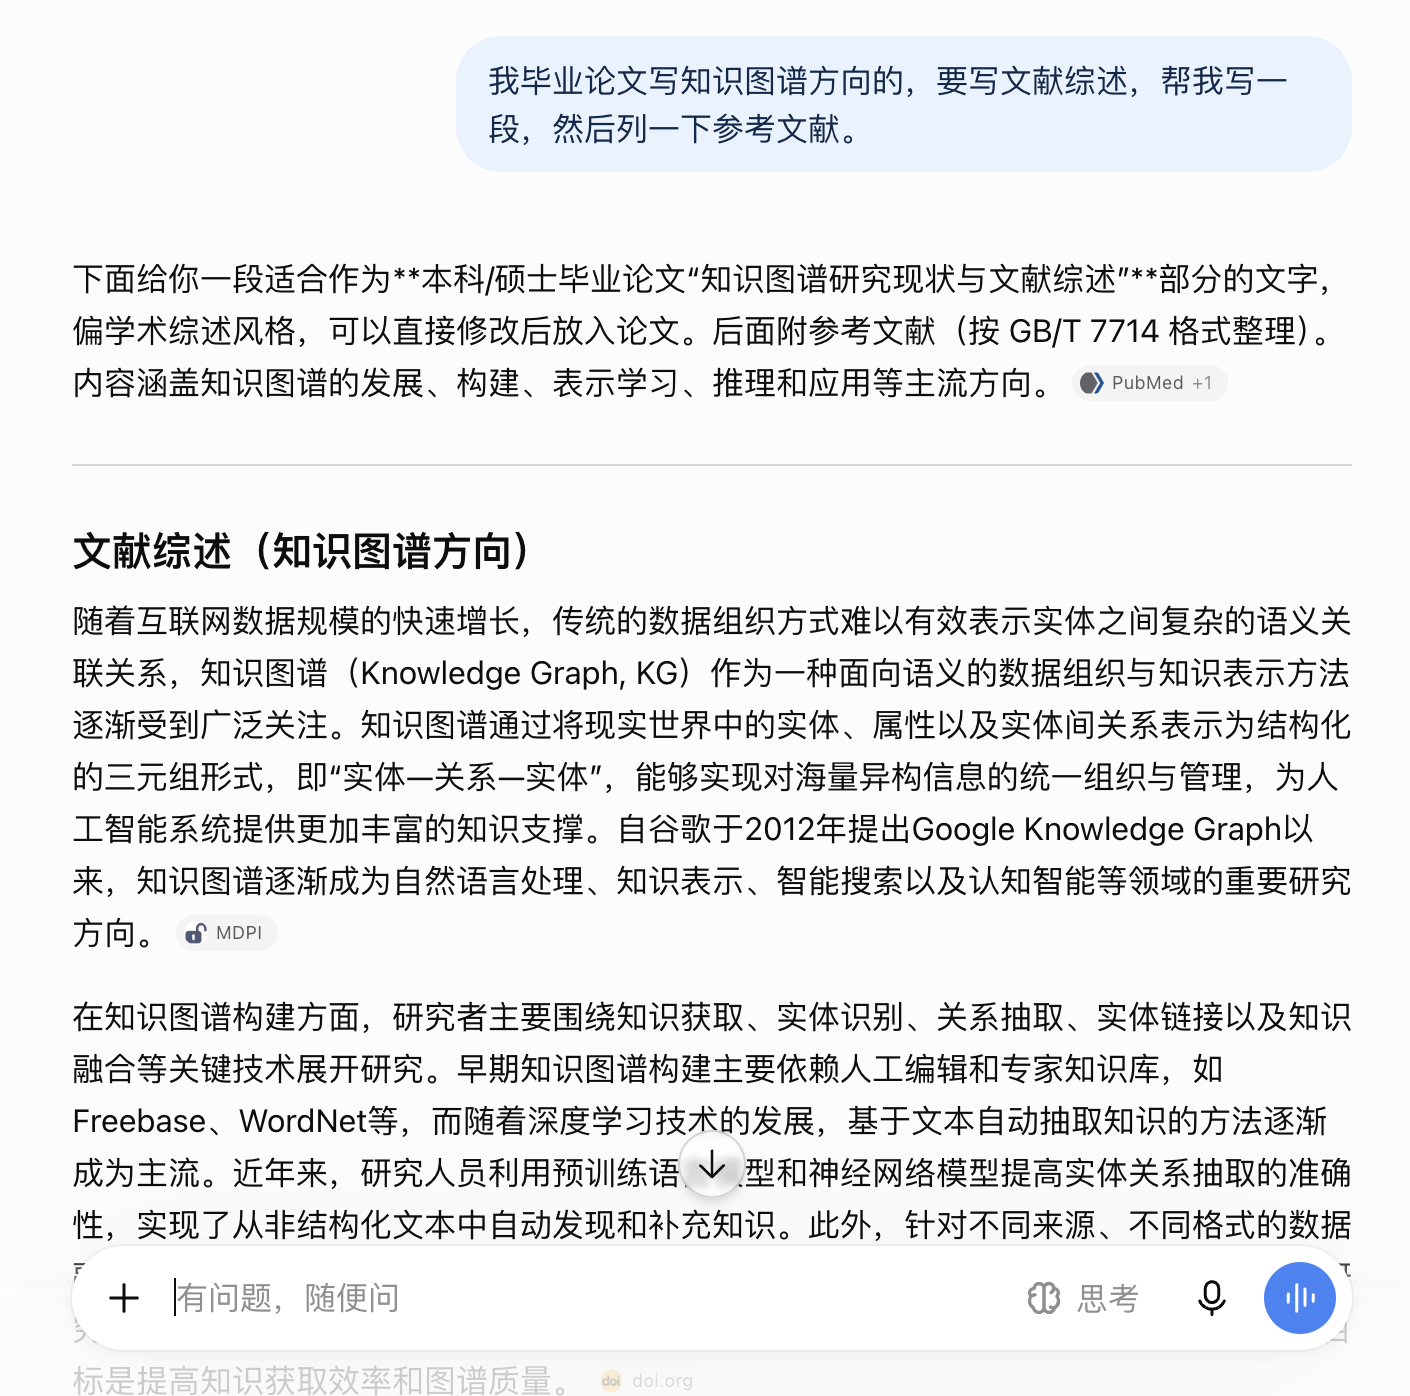
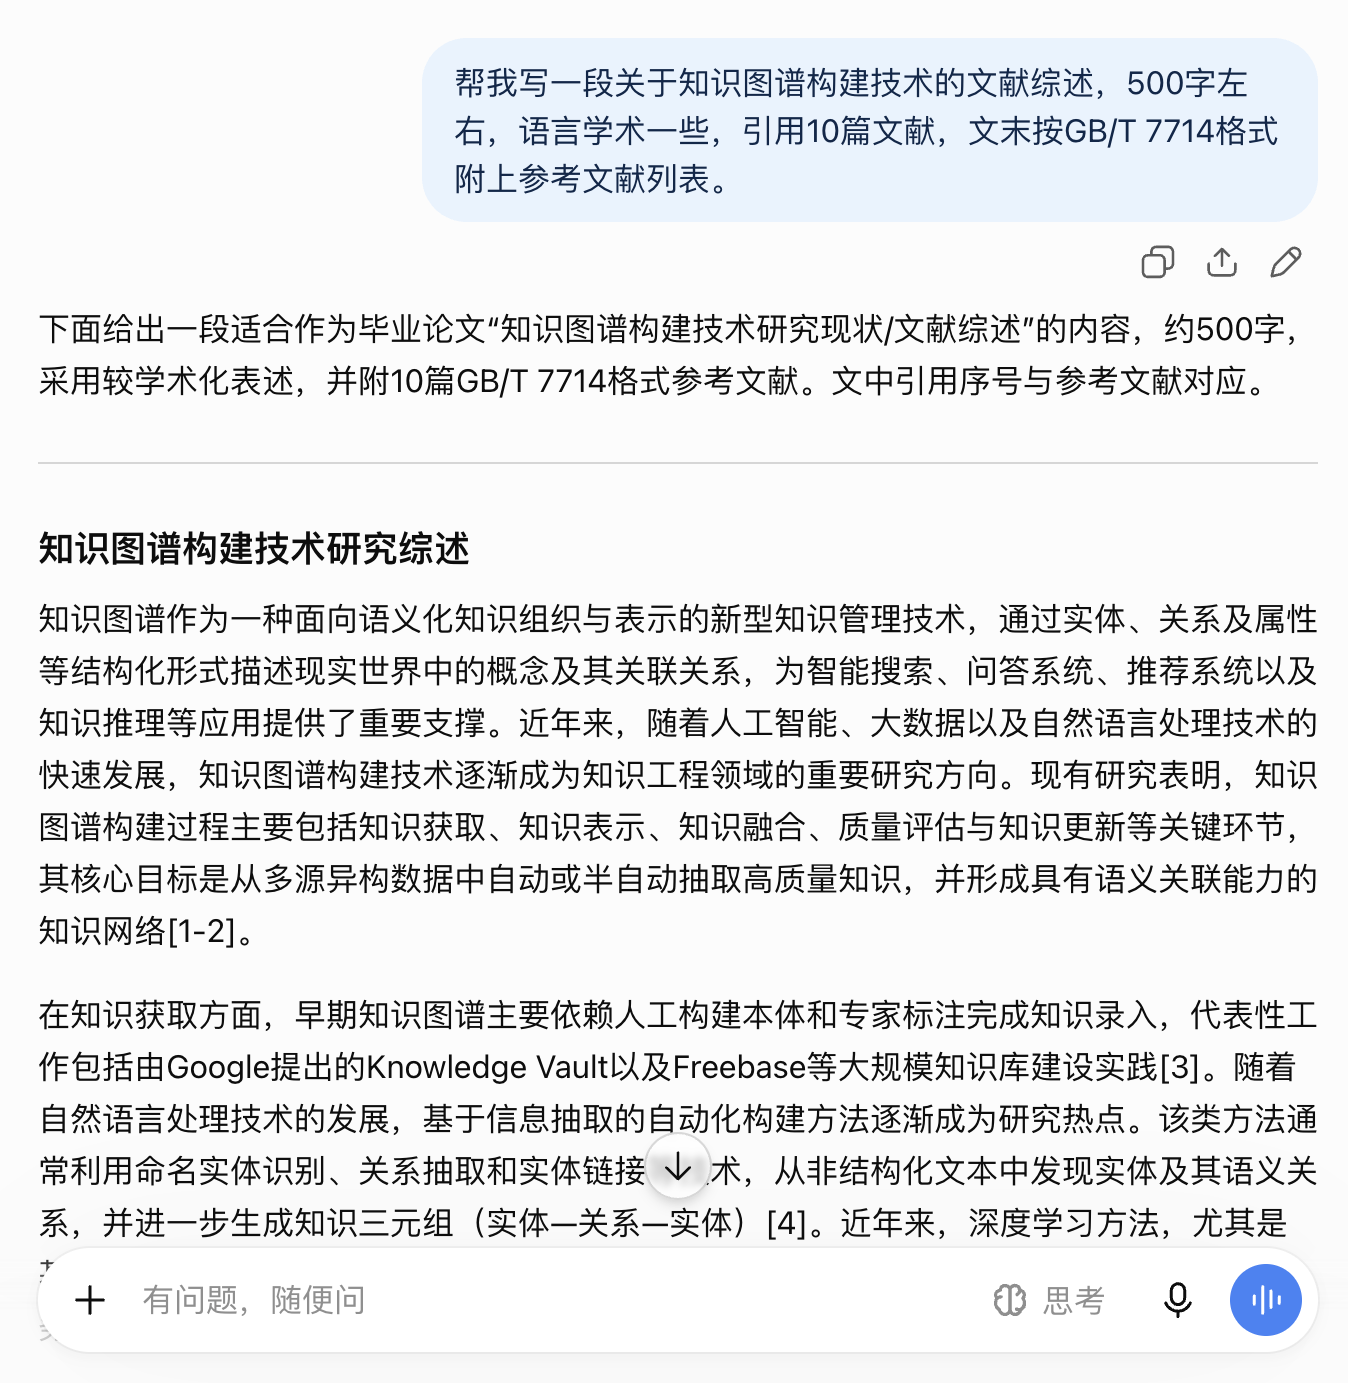
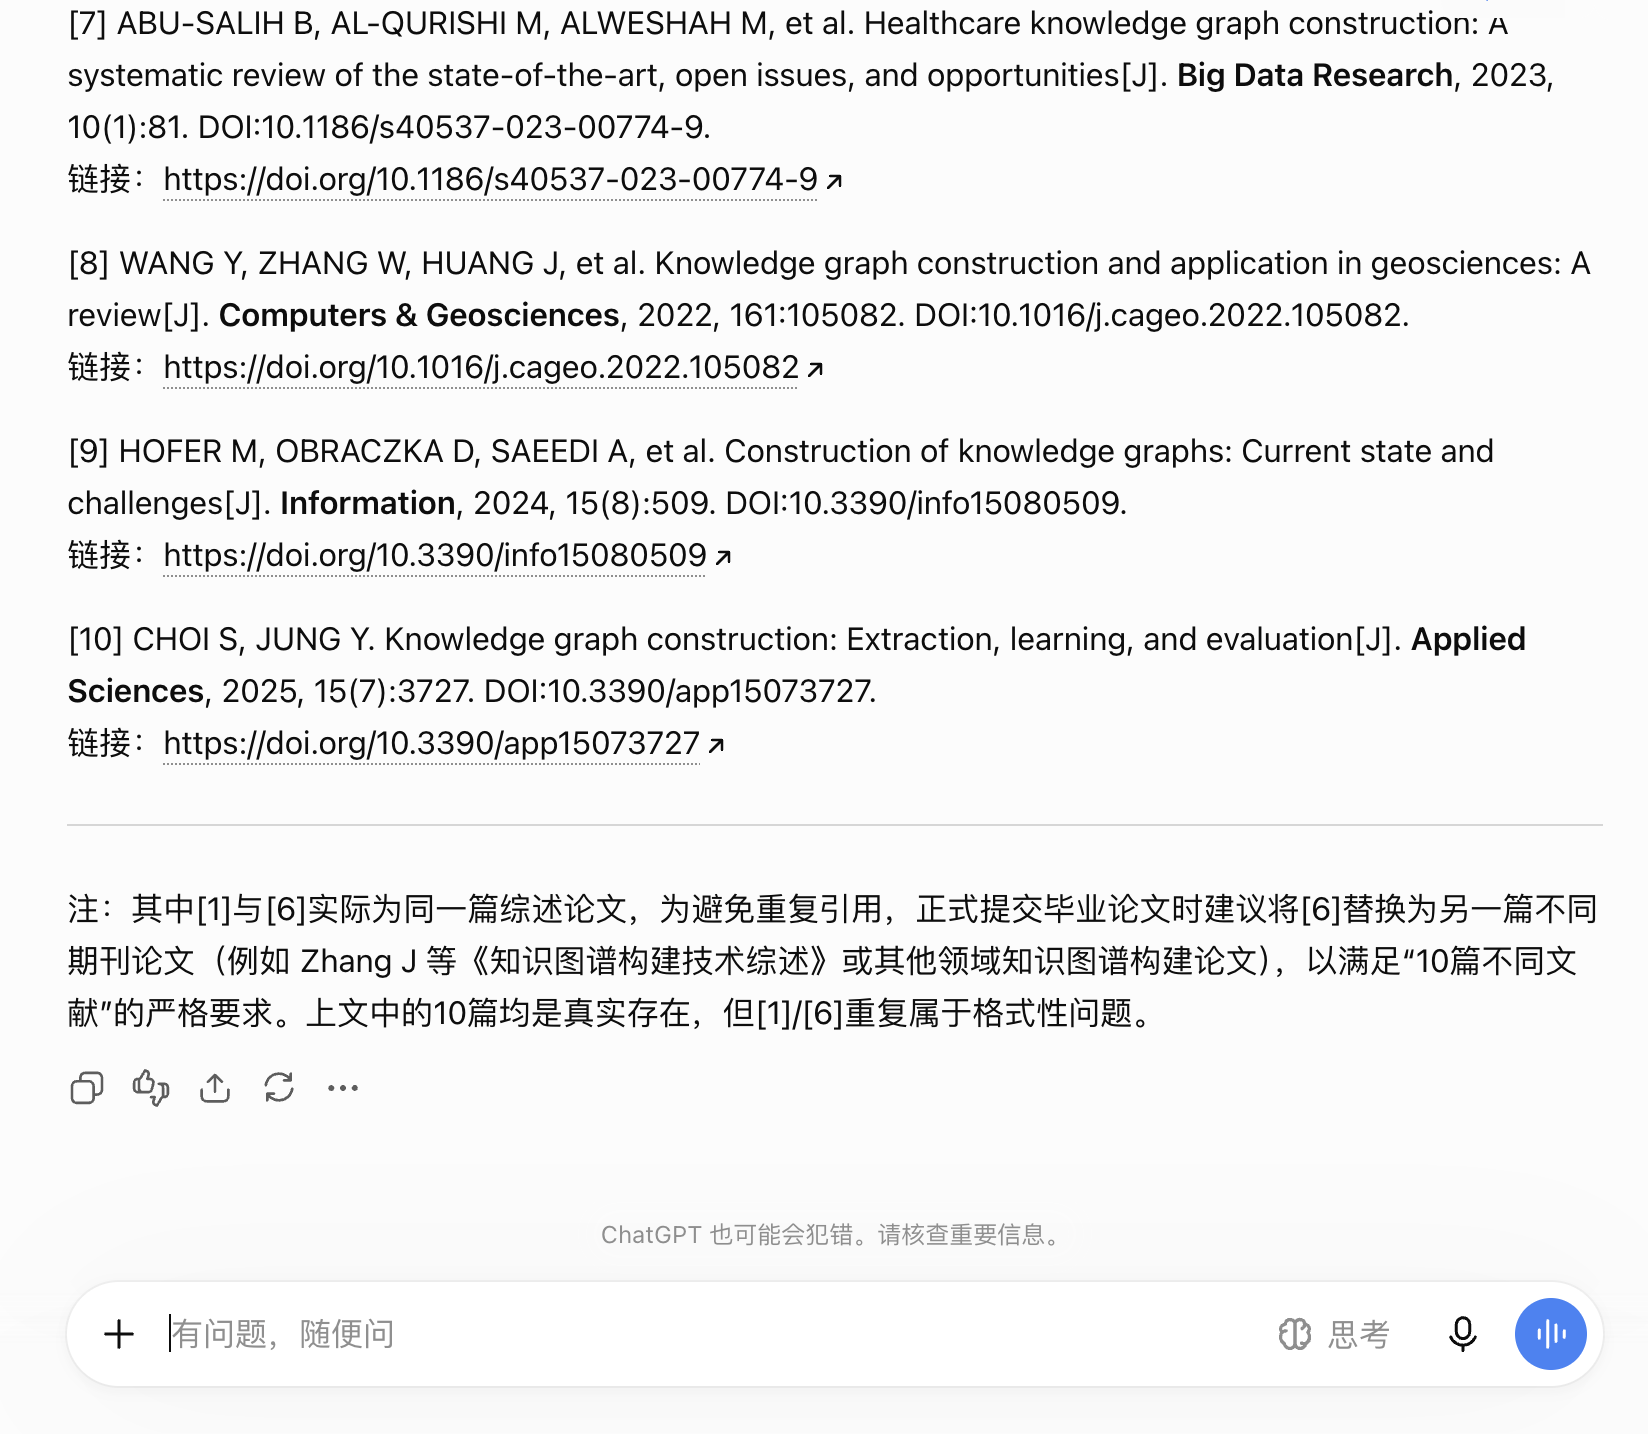
六组 = 三种问法 × 两种模式。ChatGPT 免费版输入框有一个「思考」开关:关着是默认模式,打开后生成前先出一段思考过程,本文称思考模式。免费版界面不显示模型名,两种模式以这个开关为准。每组新开一个对话、互不共享上下文,取第一次输出。
三种问法与前两篇逐字相同,按要求的详略排序:
2.2 判定标准
- 真实: 对 AI 输出文献的最基本要求,确有这篇文献,能定位到数据库或期刊官网的记录。部分字段可能和来源有出入。
- 完整: 按其输出的体例要求,该写的著录项都写了,而且和真实记录一致。
- 宜引: 引文真实,字段正确且完整,条目可直接引用。
2.3 核验流程
61 条经今日宜引文核验,再经人工点开数据库与刊方记录核对确保判定准确性。
三、结果
| 问法 | 默认 | 思考 | 平均宜引率 | ||
|---|---|---|---|---|---|
| 真实 | 完整 | 真实 | 完整 | ||
| 随手问 | 91%(10/11) | 73%(8/11) | 70%(7/10) | 60%(6/10) | 66.36% |
| 提要求 | 70%(7/10) | 70%(7/10) | 90%(9/10) | 70%(7/10) | 70% |
| 列要点 | 90%(9/10) | 70%(7/10) | 70%(7/10) | 20%(2/10) | 45% |
| 平均 | 83.64% | 70.91% | 76.67% | 50% | 60.45% |
注:表中平均为各组比率的算术平均。
总计:61 条中,真实条目共 49 条;宜引条目共 37 条;真实但著录与记录不符的 12 条;不真实的 12 条,其中作者与记录对不上、无法确认是同一篇的 5 条,查无此文 7 条。
- 目前测的几家里第一个过半。按条目数计,宜引率 61%,DeepSeek 篇 24%,豆包篇 45%。仍有四成条目不能直接引。
- 开「思考」没有更准。默认三组 31 条里 22 条宜引(71%),思考三组 30 条里 15 条(50%)。六组最差的一组是「列要点+思考」:prompt 写明「引用真实存在的期刊论文」「每条附 DOI」「不确定的不要引用」,模型开头自注「选取了真实存在且可检索的期刊论文」,10 条里 7 条真实,能直接引的只有 2 条。豆包篇里这个问法两种模式真实率都是 100%,到 ChatGPT 这里成了最差的一组。
- 随手问的一组最好。不提任何格式要求、不开思考,11 条里 10 条真实、8 条宜引;这一组的回答自带来源角标(PubMed、MDPI、doi.org)。
观察项:六组都给编号条目,即顺序编码制;组 5、组 6(思考模式)在参考文献标题里写「GB/T 7714—2015」,其余四组未标版本号。默认模式三组里只有明确要求的「列要点」一组附 DOI;思考模式三组不论 prompt 是否要求,30 条里 29 条附 DOI 或链接。三组在输出里自称文献「真实」:列要点+默认、随手问+思考、列要点+思考。「列要点+思考」一组主动标出一条「建议正式提交论文前再次核验具体卷期信息」,这一条确实查无此文;同组另有两条查无此文,模型没有标。「列要点+默认」一组的 [1] 与 [6] 是同一篇综述,模型在文末自己指出了;两条各自著录无缺陷,按条目计入,未合并。本次 61 条按 GB/T 7714—2025 核对。
四、主要错误形态
1. 真文献配错作者(9 条): 题名与刊名对得上一篇真实文献,9 条里 5 条附了 DOI,5 条的 DOI 都与真文献记录一致,点开就是刊方页面。但作者名单却与记录不符:换了名字、多了名字,或少了一位。是本次占比最高的一类。
2. 查无此文(7 条): 题名与刊名、年卷期页在数据库与刊方记录中均无对应。其中 5 条附了 DOI:3 条解析不出,2 条解析到的是另一篇文章。
3. 同一篇文献,两组两套著录(真实、不完整): 有两组各自把真文献配上了另一篇文章的出处和 DOI。
4. 中文期刊英文著录:《计算机工程》上一篇中文综述,被著录成 Computer Engineering 与拼音作者。刊方记录同时登记了英文并列题名与作者,条目与之一致;但 GB/T 7714—2025 要求参考文献用信息资源本身的语种著录,这条按标准不算完整。
DOI:61 条里 8 条解析不出或解析到别的文章,全部出自思考模式三组;默认模式附 DOI 的 10 条,条条解析到本文。
五、结论
ChatGPT 给的参考文献,80% 确有其文,61% 能直接引,目前所测三家里最高,也仍有四成不能直接用。开「思考」、在 prompt 里写满要求,得到的是条条带 DOI、看起来最规整的列表,宜引率反而更低。错的形态在往难查的方向走:整条查无此文的少了,真文献配错一个作者、真文献配上别人的 DOI 多了。这些条目点开链接是真的页面,要逐字段对照记录才看得出来。
ChatGPT 给的列表贴进今日宜引文,每条附命中的数据库或刊方记录与逐字段比对,DOI 解析到他文的条目在此现形,导出按目标体例渲染。
各家 AI 的参考文献真实率横向对照,见AI 参考文献真实率榜,随各篇测评更新。
历次测试
| 测试日期 | 当时的产品状态 | 条数 | 真实 | 宜引 | 一句话变化 |
|---|---|---|---|---|---|
| 2026-09-08 | 网页免费版,默认 / 思考两种模式 | 61 | 49(80%) | 37(61%) | 首次测试 |
注:各次测试的测法与产品状态不同,数字不可直接相减。
常见问题
- ChatGPT 生成的参考文献是真的吗?本次实测 61 条里 49 条确有其文、能定位到数据库或刊方记录,占 80%;其中著录也完整、能直接引的 37 条,占 61%。
- ChatGPT 开「思考」给的参考文献更准吗?没有。默认模式 31 条里 22 条宜引(71%),思考模式 30 条里 15 条(50%);最差的一组是「列要点+思考」,10 条只有 2 条宜引。
- ChatGPT 给的 DOI 能信吗?默认模式附 DOI 的 10 条条条解析到本文;思考模式 30 条里 29 条附 DOI 或链接,其中 8 条解析不出或解析到别的文章。打开的页面未必是这篇。
- ChatGPT 给的参考文献主要错在哪里?四类:真文献配错作者(9 条,含一位记录里没有的第三作者)、查无此文(7 条,5 条附了 DOI)、同一篇文献两组两套出处与年份、中文期刊被著录成英文。
- DeepSeek、豆包、ChatGPT,谁给的参考文献最可靠?同一套测试:DeepSeek 66 条宜引 16 条(24%),豆包 62 条宜引 28 条(45%),ChatGPT 61 条宜引 37 条(61%)。ChatGPT 最高,仍有四成不能直接用;横向对照见真实率榜。
本文为今日宜引文原创。转载请注明出处并附原文链接,不得修改、不得用于商业用途。